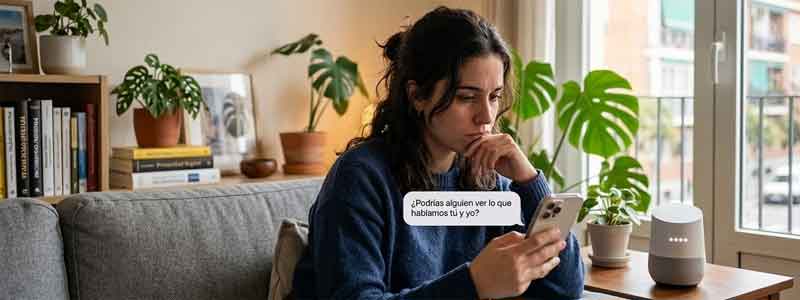
Cada vez que abres ChatGPT, Gemini o Copilot y escribes una consulta, estás cediendo información, aunque no siempre de forma consciente.
Los sistemas de inteligencia artificial procesan tus palabras, tu comportamiento y, en muchos casos, los documentos que compartes.
Por eso, entender qué ocurre con esos datos —quién los guarda, durante cuánto tiempo y para qué— es hoy una necesidad importante, no solo una preocupación técnica reservada a especialistas.
Saber cómo gestionan tus datos, qué políticas utilizan y qué derechos tienes es fundamental para proteger tu privacidad digital, pues las IA analizan los datos que introduces, pueden almacenarlos y utilizarlos para mejorar sus modelos.
Índice de contenidos
Qué hace la IA con mis datos y cómo funciona el tratamiento de la información
Cuando interactúas con una herramienta de IA, el sistema registra el contenido de tus mensajes, el contexto de la sesión y, dependiendo de la plataforma, datos adicionales como el dispositivo o la ubicación aproximada.
El tratamiento de esa información varía según:
- el proveedor
- el plan contratado
- y la configuración activa en tu cuenta.
No es lo mismo usar la versión gratuita de ChatGPT que una licencia empresarial con contrato de procesamiento de datos (DPA) firmado. La diferencia en privacidad entre ambos escenarios es sustancial y pocas veces se explica con claridad en los términos de servicio.
Por reso, para evitar brechas de seguridad o fugas de propiedad intelectual, resulta prioritario aprender a utilizar la inteligencia artificial de forma segura y profesional dentro del día a día de la empresa.
Cómo procesa la inteligencia artificial los datos introducidos por los usuarios
Cuando envías un mensaje a un LLM, el sistema lo convierte en vectores numéricos mediante embeddings y lo procesa a través de capas de atención del modelo.
Este proceso ocurre en tiempo real sobre los servidores del proveedor, no en tu dispositivo.
Los datos que introduces pueden incluir son:
- Texto libre con información personal o profesional
- Archivos adjuntos como contratos, informes o imágenes
- Datos implícitos como el idioma, el tono o la frecuencia de uso
- Metadatos de sesión: hora, dispositivo y ubicación aproximada
El procesamiento en sí no implica necesariamente almacenamiento permanente, pero sí implica que la información sale de tu entorno local y transita por infraestructura de terceros.
En la práctica, la mayoría de plataformas retienen los datos de sesión durante un periodo determinado, incluso cuando el historial está desactivado.
Lo que varía es el uso que se hace de esos datos después del procesamiento inicial.
Diferencias entre procesamiento, almacenamiento y entrenamiento de modelos de IA
Estos tres conceptos se confunden con frecuencia, pero tienen implicaciones muy distintas para tu privacidad.
- El procesamiento es la operación puntual que ejecuta el modelo para generar una respuesta.
- El almacenamiento implica que esos datos quedan registrados en los servidores del proveedor durante un tiempo definido.
- Y el entrenamiento significa que tus conversaciones se usan para mejorar o ajustar el modelo base.
Las diferencias más importantes son:
- El procesamiento ocurre siempre, independientemente de tu configuración
- El almacenamiento puede limitarse desactivando el historial, pero no siempre se elimina por completo
- El entrenamiento puede desactivarse mediante opt-out en plataformas como ChatGPT o Gemini
- El opt-out no elimina datos que ya fueron usados en entrenamientos anteriores
- No todos los proveedores ofrecen las mismas opciones de control
Entender esta distinción es fundamental para evaluar el riesgo real de cada herramienta según el tipo de información que manejas.
| Concepto | Qué implica | Cuándo ocurre | Puedes controlarlo | Riesgo para tu privacidad |
|---|---|---|---|---|
| Procesamiento | El modelo lee y analiza tu mensaje para generar una respuesta | Siempre, en cada interacción | No. Ocurre de forma inevitable en cada consulta | Medio: tus datos transitan por servidores externos |
| Almacenamiento | El contenido de la conversación queda registrado en los servidores del proveedor | Durante y después de la sesión, según la política de cada plataforma | Parcialmente: desactivando el historial se limita, pero no se elimina por completo | Alto: los datos pueden ser accesibles ante requerimiento legal o brecha de seguridad |
| Entrenamiento | Tus conversaciones se usan para ajustar o mejorar el modelo de IA | En segundo plano, tras la sesión, si no has activado el opt-out | Sí, parcialmente: mediante opt-out en plataformas como ChatGPT o Gemini | Muy alto: tus datos pasan a formar parte del modelo y no pueden recuperarse |
| Personalización | La plataforma adapta respuestas futuras en función de tu historial o memoria activa | De forma continua si tienes activada la memoria o el historial | Sí: desactivando la memoria persistente en los ajustes de la cuenta | Medio-alto: se acumula un perfil detallado de tus preferencias y comportamiento |
| Transferencia internacional | Los datos se envían a servidores ubicados fuera de la UE, normalmente en EE.UU. | En cada sesión con proveedores como OpenAI, Google o Microsoft | No directamente: depende del plan contratado y la región del servidor asignado | Alto: implica salir del ámbito de protección directo del RGPD |
| Anonimización | El proveedor elimina o enmascara los identificadores directos antes de usar los datos | Antes del entrenamiento o análisis agregado, según política interna | No: es un proceso interno del proveedor, no auditable por el usuario | Medio: la anonimización no siempre es irreversible ni verificable externamente |
¿Puede la IA revelar mis conversaciones a otras personas?
En condiciones normales, los proveedores de IA no comparten el contenido de tus conversaciones con terceros de forma directa.
Sin embargo, existen escenarios concretos en los que esa privacidad se rompe o queda en entredicho.
- El primero es el acceso interno: empleados del proveedor pueden revisar conversaciones con fines de moderación, seguridad o mejora del servicio.
- El segundo es el requerimiento legal: si una autoridad judicial lo solicita, el proveedor está obligado a entregar los datos almacenados.
- El tercero afecta a entornos corporativos: en herramientas como Microsoft Copilot integrado en Microsoft 365, los administradores de la organización pueden tener acceso a los registros de actividad de los empleados según la configuración del tenant.
Cuándo una conversación permanece privada dentro de una plataforma de IA
La privacidad real de una conversación depende de tres factores simultáneos: la política del proveedor, la configuración activa del usuario y el tipo de plan contratado.
Una conversación tiene mayor nivel de protección cuando se cumplen estas condiciones:
- El historial de conversaciones está desactivado en la cuenta
- Se utiliza un plan empresarial con DPA firmado y cláusulas de confidencialidad
- El proveedor opera bajo jurisdicción europea o con adecuación reconocida por la UE
- No se han compartido datos con plugins o integraciones de terceros
- La plataforma ofrece cifrado en tránsito y en reposo verificable
Aun así, ninguna de estas medidas garantiza privacidad absoluta. La confidencialidad total solo existe en sistemas de IA desplegados localmente, sin conexión a servidores externos.
En cualquier servicio cloud, siempre existe un nivel mínimo de acceso técnico por parte del proveedor.
Riesgos y limitaciones de privacidad en herramientas de inteligencia artificial
El uso de IA genera riesgos de privacidad que van más allá de la simple recopilación de datos.
El problema real no es solo qué guarda la plataforma, sino qué información introduces tú sin ser consciente del alcance.
Compartir datos sensibles con una IA equivale, en términos prácticos, a enviarlos a un servidor externo gestionado por una empresa privada.
Y eso implica exposición ante posibles brechas de seguridad, acceso por parte del proveedor y uso potencial para entrenar modelos futuros.
El caso Samsung de 2023 —en el que empleados filtraron código confidencial al introducirlo en ChatGPT— es el ejemplo más citado, pero no el único.
En este sentido, os riesgos son sistemáticos, no excepcionales.
Riesgos asociados al envío de información médica, financiera o legal
Introducir datos de alta sensibilidad en una herramienta de IA generativa supone aceptar implícitamente sus condiciones de tratamiento, que en muchos casos no están diseñadas para gestionar información protegida por normativas específicas.
Los riesgos concretos por tipo de dato son:
- Datos médicos: pueden vulnerar el secreto profesional sanitario y la normativa de historia clínica
- Datos financieros: números de cuenta, extractos o proyecciones quedan expuestos ante el proveedor
- Datos legales: contratos, acuerdos de confidencialidad o estrategias procesales pueden filtrarse
- Datos de terceros: compartir información de clientes sin su consentimiento puede incumplir el RGPD
- Datos de menores: su tratamiento requiere base legal reforzada que los LLMs no garantizan
En sectores regulados como salud, banca o derecho, el uso de IA generativa sin un contrato DPA específico y una evaluación de impacto (EIPD) puede constituir una infracción directa del RGPD.
Casos en los que no conviene compartir datos sensibles con una IA
Existen situaciones concretas en las que el riesgo de usar IA supera el beneficio de la automatización, por lo que identificarlas es parte de una gestión responsable de la privacidad.
No deberías introducir datos en una IA cuando:
- Manejas información cubierta por secreto profesional (médico, abogado, asesor financiero)
- La información pertenece a clientes que no han dado consentimiento explícito
- Trabajas con datos clasificados o bajo acuerdo de confidencialidad activo
- Operas en un entorno regulado sin DPA firmado con el proveedor de IA
- La plataforma no ofrece opt-out de entrenamiento verificable
La regla práctica es clara. Si no publicarías esa información en un documento público, no la introduzcas en una IA de uso general, pues el nivel de protección que ofrecen estas plataformas no equivale al de un entorno corporativo seguro.
Cómo proteger tus datos personales al utilizar inteligencia artificial
Proteger tu privacidad al usar IA no requiere renunciar a la herramienta, sino adoptar un conjunto de hábitos y configuraciones que reduzcan la exposición.
La mayoría de usuarios opera con la configuración por defecto, que suele ser la menos restrictiva en términos de privacidad.
- El primer paso es revisar qué datos compartes y con qué finalidad.
- El segundo es configurar activamente las opciones de privacidad disponibles en cada plataforma.
- El tercero es entender qué implica cada configuración, porque desactivar el historial no equivale a eliminar los datos ya procesados ni a salir del entrenamiento de modelos anteriores.
La protección real requiere acción proactiva, no confianza en los valores por defecto.
Medidas prácticas para reducir riesgos de privacidad
Estas son las acciones con mayor impacto real sobre tu nivel de privacidad al usar herramientas de IA:
- Desactiva el historial de conversaciones en tu cuenta siempre que sea posible
- Activa el opt-out de entrenamiento en ChatGPT desde Ajustes > Controles de datos
- Nunca introduzcas nombres reales, números de identificación ni datos bancarios
- Usa cuentas separadas para uso personal y profesional en plataformas de IA
- Revisa las integraciones y plugins activos: cada uno tiene su propia política de datos
- Solicita periódicamente la exportación o eliminación de tus datos desde la configuración de la cuenta
Ninguna de estas medidas ofrece privacidad absoluta, pero combinadas reducen de forma significativa la superficie de exposición y el riesgo de que tus datos se usen para fines que no has autorizado conscientemente.
Configuraciones de seguridad y control de datos que debes revisar
Cada plataforma ofrece un conjunto distinto de controles. Estos son los más relevantes que debes verificar:
- ChatGPT: Ajustes > Controles de datos → desactivar historial y opt-out de entrenamiento
- Gemini: myaccount.google.com → Actividad web y de aplicaciones → pausar el guardado
- Copilot (Microsoft): Panel de administración del tenant o configuración de privacidad de la cuenta Microsoft
- Claude (Anthropic): Política de no uso de conversaciones para entrenamiento en planes de pago; verificar en ajustes de cuenta
Revisa también si tienes activada la memoria persistente en ChatGPT, que acumula información sobre ti entre sesiones, ya que esta función amplía la personalización pero también incrementa el volumen de datos almacenados sobre tu perfil de usuario.
Diferencias de privacidad entre ChatGPT, Gemini, Claude y Copilot
No todas las plataformas de IA tratan tus datos de la misma forma.
Las diferencias en política de retención, uso para entrenamiento y opciones de control son sustanciales y deben tenerse en cuenta antes de elegir herramienta, especialmente en contextos profesionaes.
- OpenAI (ChatGPT) permite el opt-out de entrenamiento en cuentas gratuitas y de pago, pero retiene datos de conversación durante 30 días incluso con el historial desactivado.
- Google (Gemini) vincula los datos al ecosistema Google, lo que amplía el alcance del tratamiento.
- Microsoft (Copilot) ofrece garantías corporativas sólidas en su versión empresarial, con DPA incluido.
- Anthropic (Claude) tiene una política más restrictiva en cuanto al uso de datos para entrenamiento en planes de pago.
| Criterio | ChatGPT (OpenAI) | Gemini (Google) | Claude (Anthropic) | Copilot (Microsoft) |
|---|---|---|---|---|
| Uso para entrenamiento | Sí en versión gratuita; opt-out disponible en ajustes | Sí por defecto; opt-out parcial en configuración de actividad | No en planes de pago por defecto | No en Microsoft 365 Copilot con DPA activo |
| Retención de datos | 30 días con historial desactivado; indefinido con historial activo | Variable según producto Google; vinculado al ecosistema de la cuenta | Limitada en planes de pago; política más restrictiva que OpenAI | Según política del tenant corporativo; configurable por el administrador |
| Opt-out de entrenamiento | Sí, desde Ajustes → Controles de datos | Parcial, desde myaccount.google.com | Activado por defecto en planes de pago | No aplicable: los datos no se usan para entrenar modelos base |
| DPA disponible | Sí, en ChatGPT Enterprise y API | Sí, en Google Cloud y Workspace Enterprise | Sí, en planes API y Claude for Work | Sí, incluido de serie en Microsoft 365 Copilot |
| Cumplimiento RGPD | Sí, con cláusulas contractuales estándar (SCCs) | Sí, con SCCs y sede europea en Dublín | Sí, con SCCs para transferencias UE-EE.UU. | Sí, con centro de datos en la UE disponible y DPA estándar |
| Memoria persistente | Sí, activable y desactivable en ajustes | Sí, vinculada a la cuenta Google | Sí en algunos planes; configurable por el usuario | Limitada; depende de la configuración del administrador |
| Acceso de empleados del proveedor | Posible con fines de moderación y seguridad | Posible según política interna de Google | Restringido según política de Anthropic | Restringido en entornos Enterprise con DPA firmado |
| Transparencia de la política | Alta: documentación pública detallada y actualizada | Media-alta: extensa pero dispersa en el ecosistema Google | Alta: política clara y restrictiva en planes de pago | Alta en entorno corporativo; más opaca en uso consumer |
| Mejor escenario de uso | Uso general con opt-out activado; Enterprise para datos corporativos | Integración con Google Workspace en entornos con DPA | Uso profesional con datos sensibles en plan de pago | Entornos corporativos Microsoft con cumplimiento RGPD exigido |
| Peor escenario de uso | Versión gratuita con historial activo y datos sensibles | Uso sin revisar la configuración de actividad de la cuenta Google | Versión gratuita sin verificar política de retención activa | Uso consumer sin DPA ni configuración corporativa activa |
Políticas de tratamiento de datos y transparencia de los proveedores
La transparencia real de cada proveedor varía considerablemente más allá de lo que indica su página de privacidad.
Un resumen comparativo de los aspectos más relevantes:
- ChatGPT (OpenAI): retención de 30 días con historial desactivado; opt-out disponible; versión Enterprise con DPA y sin uso para entrenamiento
- Gemini (Google): datos vinculados a la cuenta Google; retención variable según producto; opt-out parcial disponible en configuración de actividad
- Copilot (Microsoft): en Microsoft 365 Copilot, los datos no se usan para entrenar modelos base; cumplimiento RGPD con DPA estándar incluido
- Claude (Anthropic): en planes de pago, las conversaciones no se usan para entrenamiento por defecto; política de privacidad más restrictiva que OpenAI
- Perplexity: retiene historial de búsquedas; opciones de privacidad más limitadas que los grandes proveedores
Por todo esto, la elección de cada plataforma debe basarse en el tipo de dato que manejas, el marco regulatorio que te aplica y las garantías contractuales que el proveedor está dispuesto a ofrecer por escrito.
Alberto Alcocer es CEO y Fundador de SocieTIC Business Online, Agencia de marketing online desde el año 2012, si bien cuenta con más de 20 años de experiencia ayudando a las empresas a incrementar su volumen de Leads y clientes en internet
Su enfoque se centra en la rentabilidad y la estrategia de negocio, habiendo ayudado a cientos de empresas a incrementar sus ventas en internet mediante el marketing online.
Es formador, docente en programas de Máster, y Speaker Internacional en congresos y eventos de marketing, habiendo participado en más de 30 en España, México, Ecuador, Colombia, Perú, Argentina y Honduras»
Otros post relacionados
 ¿Qué son los hiperparámetros de ChatGPT y cómo utilizarlos para mejorar el rendimiento de ChatGPT?
 15 mejores herramientas para crear imágenes con IA. Despierta tu creatividad
 Cómo usar ChatGPT para la planificación de contenidos para tu blog
 Aspectos legales y éticos sobre el uso de ChatGPT y la IA en tu empresa